Gemini heeft slechts 30 seconden nodig om je stem te klonen
Google maakt het wel heel makkelijk een stem digitaal na te bootsen. Met de nieuwe Gemini 3.8 Flash TTS-modellen kan een stem worden gerepliceerd op basis van slechts 30 seconden audio. De technologie is bedoeld voor onder meer podcasts, audioboeken, games en AI-assistenten.
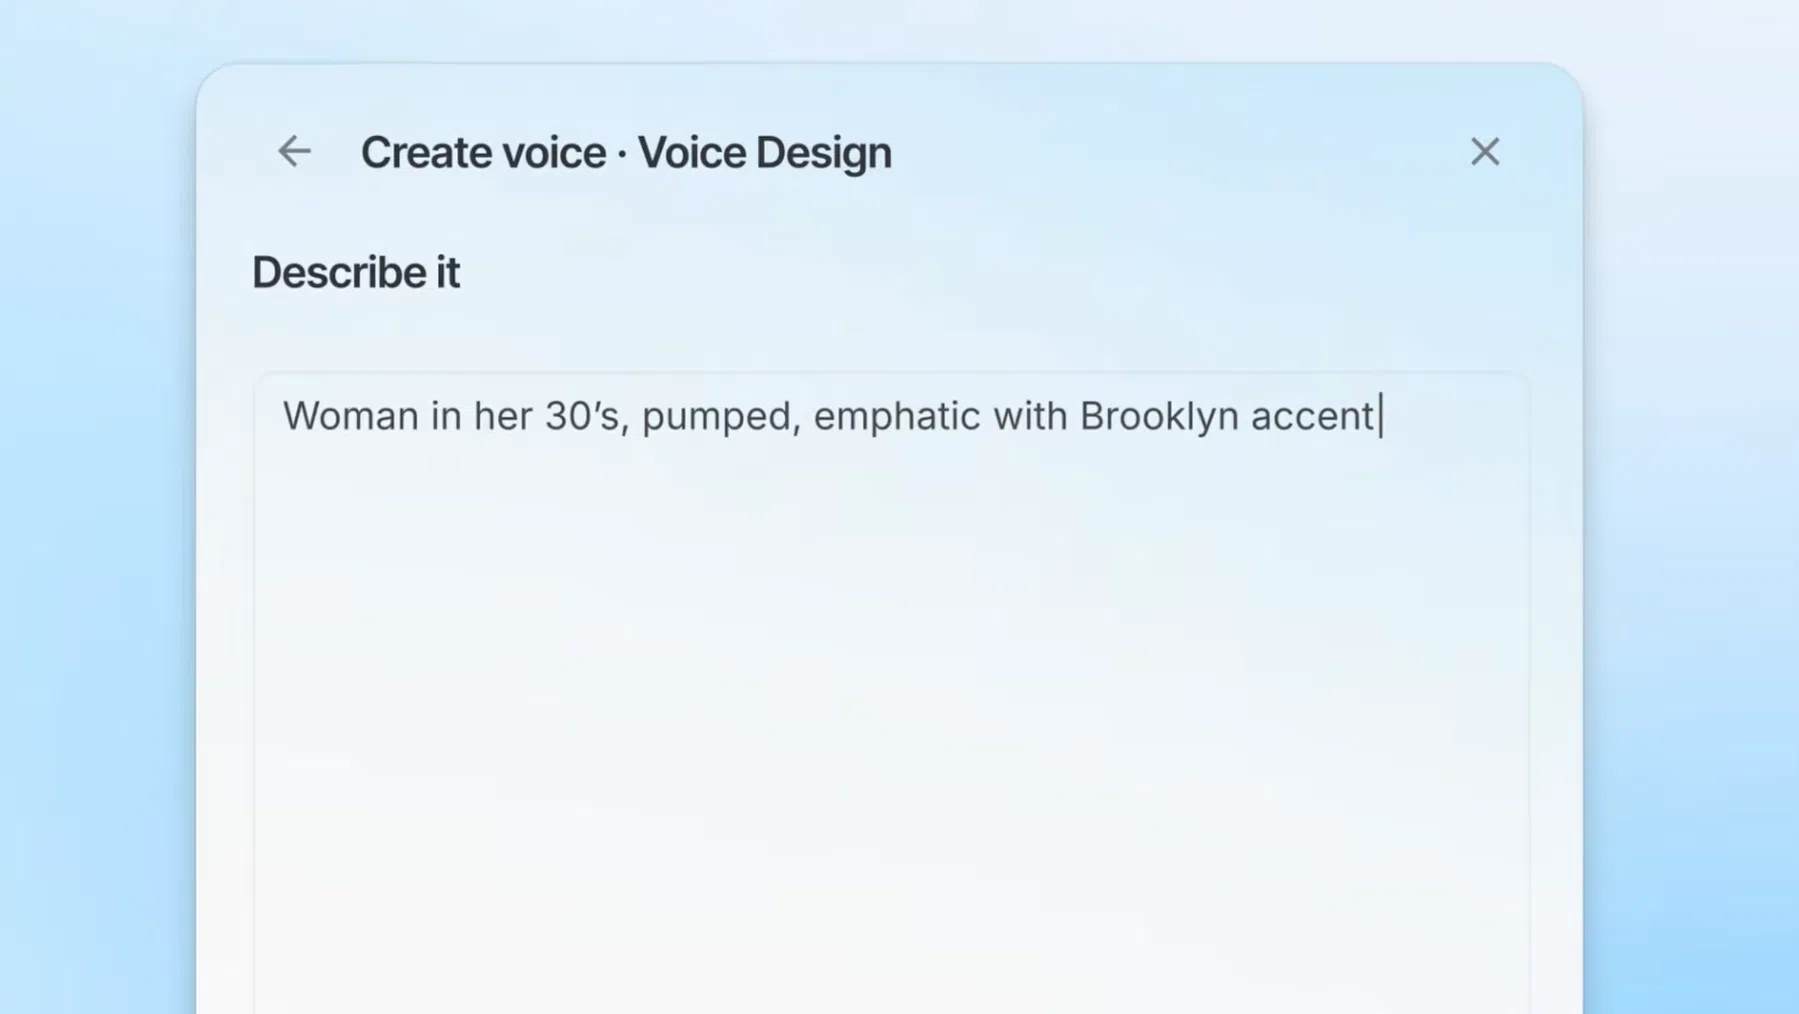
Google introduceert twee nieuwe modellen met de naam Gemini 3.8 Flash TTS en de goedkopere Flash-Lite-variant. De eerste is echt gericht op makers van content. Daarmee kunnen gebruikers niet alleen bestaande stemmen nabootsen, maar ook volledig nieuwe stemmen ontwerpen. Via tekstcommando’s zijn onder meer accent, karakter, tempo en manier van spreken aan te passen.
Wie een bestaande stem wil klonen, hoeft volgens Google slechts een geluidsfragment van dertig seconden aan te leveren. Daarvoor moet wel toestemming worden gegeven door de eigenaar van de stem. Google zegt hiervoor een verificatiesysteem te gebruiken waarbij de eigenaar een gesproken toestemmingsverklaring moet opnemen. Toch klinkt dit als iets waar Google in de toekomst mogelijk nog problemen mee gaat krijgen.
Meer dan praten alleen
De nieuwe modellen moeten veel meer kunnen dan tekst simpelweg hardop voorlezen. Gebruikers kunnen per zin aangeven hoe iets uitgesproken moet worden. Denk aan fluisteren, lachen, zuchten of een bepaalde emotie. Ook stiltes en korte reacties zoals ‘mhm’ kunnen worden toegevoegd.
Het is tevens mogelijk twee stemmen vanuit één script met elkaar te laten praten. Dat maakt de technologie interessant voor bijvoorbeeld fictieve podcasts, audioboeken en dialogen in games. Volgens Google kunnen de modellen bovendien urenlange audio produceren zonder dat de stem van een personage sterk verandert.
Google zegt inmiddels meer dan 2.000 kant-en-klare stemmen beschikbaar te hebben, met ondersteuning voor meer dan honderd talen en dialecten.
Het Amerikaanse techbedrijf voorziet gegenereerde audio automatisch van een onzichtbaar SynthID-watermerk. Daarmee moet later kunnen worden vastgesteld dat een fragment door AI is gemaakt. Ook worden C2PA-gegevens gebruikt voor herkomstinformatie.
De nieuwe spraakmodellen zijn vanaf vandaag beschikbaar via de Gemini API en Google AI Studio. Gemini 3.8 Flash TTS komt daarnaast naar Gemini Notebook, terwijl Flash-Lite wordt toegevoegd aan Google Vids.